Машина исполняется на A
Приложение работает в гостевой ОС на хосте A, а оперативная память занята страницами гостя. Для планового переноса платформа проверяет совместимость B, свободные ресурсы и доступ к дискам и сети.
На физическом сервере A работает виртуальная машина (VM) с приложением. Хост B может читать её диск и подключён к нужной сети. Плановое обслуживание A и внезапный отказ A приводят к двум разным сценариям.
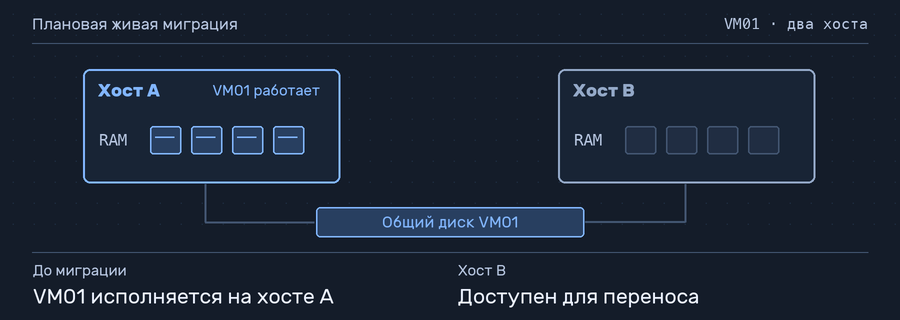
Приложение работает в гостевой ОС на хосте A, а оперативная память занята страницами гостя. Для планового переноса платформа проверяет совместимость B, свободные ресурсы и доступ к дискам и сети.
В рассматриваемом варианте живой миграции A продолжает исполнять гостя, пока содержимое его памяти передаётся на B. Страницы, изменившиеся во время копирования, отмечаются и передаются ещё раз. Диск в этом примере уже доступен обоим хостам.
Платформа ненадолго приостанавливает VM на A, переносит оставшиеся изменения и состояние процессоров и устройств. На B гость продолжает с сохранённой позиции. Сеть должна доставлять последующие кадры к VM на новом хосте.
Если A внезапно отказал до переноса, в работу вступает настроенная система высокой доступности, HA. После определения отказа и выбора узла она заново запускает VM на B с доступного диска. Гостевая ОС загружается и снова запускает приложение.
| Условие | Живая миграция | Перезапуск после отказа |
|---|---|---|
| Хост A | Исправен | Отказал |
| Память гостя | Содержимое переносится на B | Выделяется для новой загрузки |
| Гостевая ОС на B | Продолжает с перенесённого состояния | Загружается с диска VM |
| Приложение | Продолжает исполняться | Запускается и восстанавливает работу |
В обеих ситуациях B нужны доступ к дискам и сети виртуальной машины, свободная память и процессорное время.
Живую миграцию применяют при обслуживании хоста или перераспределении нагрузки. Её условия зависят от платформы, процессоров, устройств, сети и хранения. При локальных дисках понадобится механизм переноса или репликации данных. При быстром изменении памяти передать страницы за короткую паузу сложнее.
После аварии время простоя включает обнаружение отказа, решение кластера, запуск VM, загрузку гостевой ОС и восстановление приложения. Сервис для пользователя возвращается, когда приложение готово принять запрос. Кластер самого приложения может переключить запросы на уже работающий экземпляр по своим правилам.
Если хосты потеряли общее хранилище, оба лишатся доступа к виртуальным дискам. При оценке схемы отдельно рассматривают питание и вычисления, сеть VM, управление и хранилище. Функции сетей миграции, хранения и приложений могут использовать разную или общую физическую инфраструктуру.
Запас N+1 рассчитывают на выбранный отказ. Например, три равных хоста загружены по CPU на 60%. Если работа равномерно перераспределится, после отказа одного на двух оставшихся получится по 90%. Отдельно считают память и другие ресурсы, нужные для всех перезапускаемых VM.
Когда связь между участками кластера пропадает, каждый из них может продолжать видеть свои узлы. Правила кворума и, на некоторых платформах, отдельный свидетель помогают определить, какая сторона вправе продолжать работу. Контроль владения ресурсом защищает общий диск от одновременного запуска одной VM в двух местах.